Le célèbre challenge Titanic de Kaggle constitue un exercice classique de classification supervisée : prédire la survie des passagers à partir de leurs caractéristiques.
L’objectif de ce projet va toutefois au-delà de la compétition. Il consiste à transformer un modèle de Machine Learning en un service exploitable, depuis la préparation des données jusqu’à son exposition via une API REST et une application interactive.
Cette démarche permet d’aborder plusieurs problématiques de Data Science et de ML Engineering : ingénierie des variables, validation des modèles, reproductibilité, inférence, explicabilité et déploiement.
80%
Accuracy locale
SVC RBF
Modèle retenu
FastAPI
API REST
1. Contexte et objectifs#
1.1. Le problème de classification#
Le Titanic a sombré dans l’Atlantique Nord en avril 1912. Les données mises à disposition par Kaggle permettent d’étudier les caractéristiques des passagers et leur association avec la probabilité de survie.
Deux jeux de données sont fournis :
| Dataset | Observations | Particularité |
|---|---|---|
| Entraînement | 891 | Variable cible Survived disponible |
| Test | 418 | Variable cible masquée pour la compétition |
La variable cible est binaire :
0: passager décédé ;1: passager survivant.
Le problème consiste à construire un classifieur capable d’estimer la probabilité de survie à partir des informations disponibles.
1.2. Les objectifs techniques#
Le projet poursuit trois objectifs complémentaires :
- Construire un modèle prédictif en comparant différentes approches de classification et en développant des variables explicatives pertinentes.
- Structurer un pipeline reproductible, séparant les étapes d’exploration, de préparation, d’entraînement et d’inférence.
- Exposer le modèle sous forme de service, grâce à une API FastAPI et une application interactive Streamlit, avec un mécanisme d’explicabilité SHAP.
Titanic est un jeu de données pédagogique, et non un cas d’usage industriel réel. L’intérêt du projet réside principalement dans la méthodologie, l’architecture logicielle et les problématiques rencontrées lors du passage d’un modèle expérimental à une application utilisable.
2. Exploration et préparation des données#
2.1. Analyse exploratoire#
Une première analyse descriptive permet d’identifier les distributions, les valeurs manquantes et les relations entre les caractéristiques des passagers et leur survie.
Deux variables présentent notamment une proportion importante de valeurs manquantes :
| Variable | Valeurs manquantes |
|---|---|
Age | 19,9 % |
Cabin | 77,1 % |
Embarked | 0,2 % |
Ces premières analyses permettent d’orienter la préparation des données et la construction de nouvelles variables.
Plusieurs constats ressortent :
- Valeurs manquantes : la variable
Cabinest très incomplète, mais la présence ou l’absence d’une information de cabine peut elle-même constituer une caractéristique utile. - Sexe et classe : les taux de survie présentent des différences importantes selon le sexe et la classe du billet.
- Structure familiale : les informations relatives aux proches et aux billets partagés suggèrent l’intérêt de construire des variables décrivant les groupes de passagers.
Ces observations motivent les transformations présentées dans la section suivante, sans préjuger de leur contribution effective aux performances du modèle.
2.2. Feature engineering#
Les variables initiales ne sont pas toutes directement adaptées à la modélisation.
Une partie du travail consiste à construire de nouvelles caractéristiques à partir des informations disponibles.
| Variable | Construction ou interprétation |
|---|---|
Title | Extraction du titre à partir du nom |
HasNickname | Présence d’un surnom |
IsChild | Indicateur permettant d’identifier les jeunes enfants |
IsAlone | Passager voyageant sans proche identifié |
FamilySize | Taille du groupe familial déclaré |
FarePerPerson_log1p | Transformation logarithmique du tarif estimé par personne |
HasCabin | Présence d’une information de cabine |
FamilySurvivalRate | Information de survie associée au groupe familial |
TicketSurvivalRate | Information de survie associée aux passagers partageant un billet |
Les variables familiales et liées au billet présentent un intérêt particulier.
En effet, les passagers ne sont pas nécessairement indépendants : plusieurs personnes peuvent appartenir à une même famille ou voyager avec un billet commun.
Cette information peut améliorer la prédiction, à condition d’être utilisée correctement lors de la validation et de l’inférence.
2.3. Préparation des variables#
Les principales transformations portent sur :
- L’imputation des valeurs manquantes, notamment pour l’âge.
- L’encodage des variables catégorielles.
- La transformation ou la standardisation des variables numériques lorsque nécessaire.
- La sélection des caractéristiques retenues pour le modèle final.
Ces traitements sont intégrés dans un pipeline scikit-learn, permettant d’appliquer de manière cohérente le prétraitement et la classification.
3. Modélisation et évaluation#
3.1. Comparaison des algorithmes#
Plusieurs familles de modèles ont été expérimentées lors de la phase initiale :
- Régression logistique.
- Arbres de décision et Random Forest.
- Gradient Boosting et XGBoost.
- K-Nearest Neighbors.
- Support Vector Classifier (SVC).
- Méthodes d’ensemble.
Le benchmark historique avait notamment produit les résultats suivants :
| Algorithme | Accuracy en validation croisée |
|---|---|
| SVC | 82,61 % |
| XGBoost | 82,16 % |
| Gradient Boosting | 81,26 % |
| Régression logistique | 81,03 % |
| Random Forest | 80,93 % |
Ces résultats correspondent à une phase exploratoire antérieure du projet. Ils ne constituent pas une comparaison expérimentale avec le modèle final, dont les variables et les modalités d’évaluation ont évolué.
3.2. Modèle final : SVC à noyau RBF#
Le modèle finalement retenu repose sur un Support Vector Classifier (SVC) avec un noyau radial, ou RBF (Radial Basis Function).
Ce type de modèle permet d’apprendre des frontières de décision non linéaires entre les deux classes.
La configuration retenue comprend notamment :
| Paramètre | Valeur |
|---|---|
| Algorithme | SVC |
| Noyau | RBF |
C | 2 |
gamma | scale |
| Probabilités | Activées |
Le modèle est intégré dans un pipeline scikit-learn, puis sérialisé au format joblib afin de pouvoir être chargé par le service de prédiction.
3.3. Résultats#
Le modèle final SVC à noyau RBF obtient une accuracy de 80,14 % lors de son évaluation locale.
Ce résultat est cohérent avec les performances observées lors des premières expérimentations, même si les configurations et les protocoles d’évaluation ont évolué entre les différentes versions du projet.
Il doit toutefois être interprété avec prudence : certaines variables construites à partir des informations de survie d’autres passagers peuvent introduire un biais optimiste dans l’évaluation.
Ces limites, ainsi que les différences entre entraînement et inférence via l’API, sont détaillées dans la section 8.
L’accuracy ne constitue qu’une mesure globale de classification. Dans le cadre de Titanic, elle permet de comparer les modèles, mais ne renseigne pas à elle seule sur les erreurs propres à chaque classe ou sur la qualité des probabilités prédites.
4. Architecture du service de Machine Learning#
La principale évolution du projet réside dans le passage d’un workflow expérimental à une architecture séparant entraînement, exposition du modèle et interface utilisateur.
4.1. Vue d’ensemble#
flowchart TB
    A["Données Titanic
Kaggle"]
    B["Nettoyage et
feature engineering"]
    C["Prétraitement
scikit-learn"]
    D["Entraînement
SVC RBF"]
    E["Pipeline sérialisé
model.joblib"]

    F["Application
Streamlit"]
    G["API REST
FastAPI"]
    H["Prédictions
et probabilités"]
    I["Explicabilité
 SHAP"]

    A --> B
    B --> C
    C --> D
    D --> E

    F <-->|"Requêtes HTTP / JSON"| G
    E --> G
    G --> H
    G --> I
    H --> G
    I --> G

    classDef data fill:#e8eef8,stroke:#5376a6,color:#172b4d
    classDef ml fill:#dcefe7,stroke:#42866b,color:#173e30
    classDef service fill:#e8e5f6,stroke:#8174b5,color:#30245b

    class A,B data
    class C,D,E ml
    class F,G,H,I service
Architecture fonctionnelle du service Titanic ML.
Cette organisation repose sur deux parcours.
Entraînement : les données sont préparées, les variables construites, le modèle entraîné, puis le pipeline sauvegardé.
Inférence : l’application Streamlit transmet les caractéristiques d’un passager à FastAPI, qui charge le pipeline entraîné pour calculer la prédiction et renvoyer les résultats.
L’entraînement n’a donc pas besoin d’être relancé à chaque requête.
4.2. Reproductibilité et organisation du projet#
Le dépôt GitHub sépare les notebooks exploratoires du code réutilisable.
Les principales composantes sont :
| Composant | Rôle |
|---|---|
notebooks/ | Exploration, expérimentations et benchmark |
src/titanic/ | Préparation des données, features et modélisation |
scripts/ | Construction du dataset, entraînement, prédiction, évaluation |
models/ | Artefacts de modèles |
tests/ | Tests automatisés |
pyproject.toml | Configuration et dépendances |
Makefile | Automatisation des commandes |
La gestion de l’environnement repose sur uv, tandis que le Makefile permet de déclencher les principales étapes du pipeline.
make build
make train
make predict
make evaluate
Cette organisation vise à rendre les expérimentations reproductibles et à limiter la dépendance aux notebooks.
5. Exposition du modèle via FastAPI#
Un modèle entraîné dans un notebook n’est pas directement utilisable par une application externe.
Pour permettre son exploitation, une API REST développée avec FastAPI assure l’interface entre les données reçues et le pipeline de prédiction.
5.1. Fonctionnement de l’API#
Le principe est le suivant :
- Un client transmet les caractéristiques d’un passager au format JSON.
- L’API vérifie et prépare les informations nécessaires.
- Le pipeline chargé en mémoire applique les transformations attendues.
- Le modèle calcule une classification et une probabilité estimée.
- Le résultat est retourné au client.
La séparation entre le modèle et son interface d’utilisation permet d’envisager plusieurs consommateurs : application web, scripts Python ou autres services.
5.2. Endpoints#
Plusieurs endpoints ont été développés pour couvrir les principaux besoins du service.
| Endpoint | Fonction |
|---|---|
/health | Vérification de l’état du service |
/model-info | Consultation des informations du modèle |
/predict | Calcul d’une prédiction |
/what-if | Exploration de scénarios alternatifs |
/explain | Explication d’une prédiction |
Les endpoints de prédiction constituent le cœur de l’application.
Les autres routes complètent le service avec des fonctionnalités d’observation, d’analyse et d’interprétation.
5.3. Simulation de scénarios#
La fonctionnalité what-if permet d’étudier l’effet d’une modification des caractéristiques transmises au modèle.
Par exemple, deux profils peuvent être comparés en faisant varier la classe du billet ou l’âge du passager.
Cette approche permet d’observer comment la prédiction évolue selon les variables d’entrée.
Une simulation what-if ne constitue pas une estimation causale. Modifier une variable dans le modèle permet d’étudier sa sensibilité prédictive, mais pas de démontrer qu’une intervention réelle aurait produit le même effet sur la survie.
6. Explicabilité des prédictions avec SHAP#
Un modèle prédictif ne devrait pas être évalué uniquement à partir de ses performances globales.
Il est également utile de comprendre les caractéristiques qui contribuent aux prédictions individuelles.
6.1. Principe de SHAP et importance globale des variables#
SHAP (SHapley Additive exPlanations) est une méthode d’explicabilité fondée sur les valeurs de Shapley, issues de la théorie des jeux coopératifs.
Elle cherche à attribuer une contribution aux variables utilisées par un modèle, relativement à une prédiction de référence.
Une première analyse SHAP permet d’identifier les variables ayant le plus d’influence sur les prédictions du modèle.
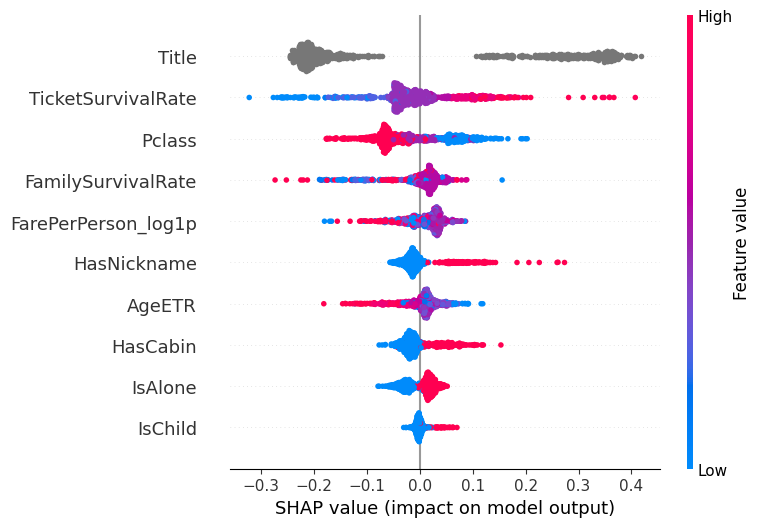
Chaque point représente un passager. Sa position horizontale indique la contribution de la variable à la sortie du modèle :
- Valeur SHAP positive : contribution orientée vers une probabilité de survie plus élevée.
- Valeur SHAP négative : contribution orientée vers une probabilité de survie plus faible.
- Couleur : valeur de la caractéristique, du bleu (faible) au rouge (élevée), lorsque cette représentation est applicable.
Les variables sont classées selon leur importance moyenne en valeur absolue.
Les résultats mettent notamment en évidence trois caractéristiques importantes : Title, TicketSurvivalRate et Pclass.
L’étalement des contributions montre également que l’influence d’une variable peut varier fortement selon les profils de passagers.
6.2. Explication locale d’une prédiction#
SHAP peut également être utilisé pour expliquer une prédiction individuelle.
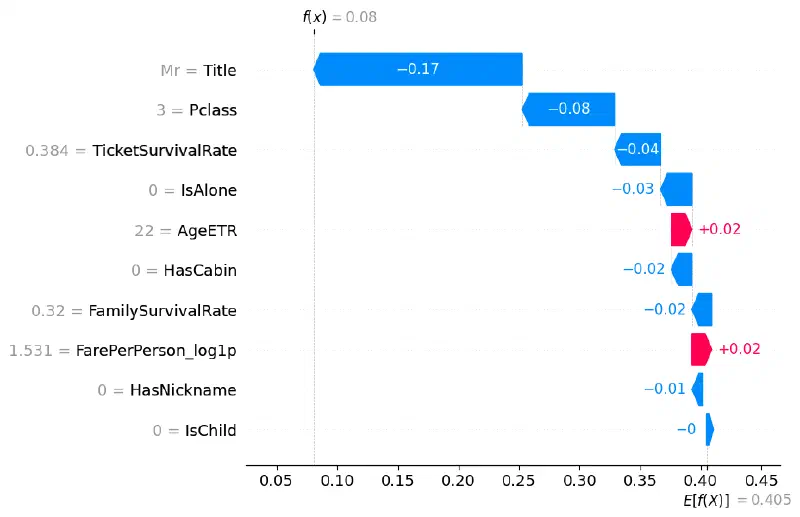
Dans cet exemple, le modèle estime une probabilité de survie d’environ 8 %, contre une valeur de référence de 40,5 %.
Plusieurs caractéristiques contribuent à cette diminution :
Title = Mr: contribution d’environ −17 points de pourcentage.Pclass = 3: contribution d’environ −8 points.TicketSurvivalRate: contribution d’environ −4 points.
À l’inverse, certaines variables, notamment AgeETR et FarePerPerson_log1p, apportent des contributions légèrement positives.
Ce graphique permet de comprendre comment les caractéristiques du passager contribuent à l’écart entre la prédiction individuelle et la valeur de référence.
Ces contributions décrivent le fonctionnement du modèle : elles ne constituent pas des effets causaux sur la survie réelle du passager.
7. Application interactive avec Streamlit#
Une interface web a été développée avec Streamlit afin de rendre le modèle accessible sans nécessiter de connaissances en Python ou en API REST.
L’utilisateur peut renseigner les caractéristiques d’un passager et demander une prédiction.
7.1. Interaction avec FastAPI#
L’application Streamlit joue le rôle de client de l’API FastAPI.
Elle permet de :
- Saisir les informations d’un passager.
- Envoyer une demande de prédiction.
- Afficher les résultats retournés par le modèle.
- Exploiter les fonctionnalités d’analyse proposées par le service.
Les requêtes sont transmises à FastAPI, qui exécute le pipeline de Machine Learning et retourne les résultats.
Ce découplage permet de faire évoluer séparément l’interface utilisateur et les traitements prédictifs.
7.2. Du notebook à l’application#
L’intérêt de cette dernière étape est de sortir du cadre habituel d’une expérimentation locale.
Le modèle devient accessible à travers une interface dédiée, avec un contrat d’échange entre le client et le service de prédiction.
Le projet illustre ainsi une chaîne complète :
Données → Feature engineering → Entraînement → Modèle sérialisé → API → Application.
8. Limites et perspectives#
Malgré le fonctionnement du service, plusieurs limites techniques doivent être distinguées.
8.1. Risques de fuite de données#
Les variables FamilySurvivalRate et TicketSurvivalRate utilisent des informations associées aux résultats de survie d’autres passagers.
Elles peuvent améliorer la performance prédictive, mais nécessitent une attention particulière.
Lors de la validation, les valeurs de ces variables doivent être construites sans exploiter les cibles du pli utilisé pour l’évaluation.
Une stratégie leave-one-out peut éviter qu’une observation utilise directement sa propre cible, mais ne suffit pas nécessairement à supprimer les fuites entre les plis d’une validation croisée.
Une perspective d’amélioration consiste donc à renforcer la construction de ces variables à l’intérieur de chaque étape de validation.
8.2. Parité entre entraînement et inférence#
Certaines informations disponibles pendant l’entraînement ne le sont plus nécessairement lorsqu’un nouveau passager est soumis à l’API.
C’est notamment le cas des taux de survie associés aux familles ou aux groupes de billets.
Dans ces situations, des mécanismes de repli peuvent être nécessaires.
Cependant, ces valeurs de substitution peuvent modifier la distribution des données transmises au modèle par rapport à celles utilisées pendant l’entraînement.
Ce problème de parité entraînement/inférence constitue une limite importante du service actuel.
Pour une utilisation plus robuste, plusieurs améliorations seraient envisageables :
- Centraliser davantage la logique de calcul des variables entre entraînement et API.
- Conserver les informations historiques nécessaires dans un référentiel accessible au service.
- Tester systématiquement la cohérence entre les transformations effectuées à l’entraînement et à l’inférence.
- Évaluer le modèle sur les données réellement produites par l’API, y compris dans les situations où certaines informations sont absentes.
8.3. Évaluation et déploiement#
La performance mesurée sur Kaggle ne garantit pas à elle seule une performance identique pour les profils saisis via l’application.
Une évaluation de bout en bout reste donc nécessaire pour caractériser correctement le service.
D’autres perspectives concernent la couverture des tests, la gestion des erreurs, le suivi des versions du modèle et l’automatisation du déploiement.
Le principal enseignement de ce projet est que la qualité d’un service de Machine Learning ne dépend pas uniquement du score de son modèle. Elle repose aussi sur la cohérence des transformations, la reproductibilité des expérimentations, la fiabilité des interfaces et la capacité à interpréter les résultats.
9. Conclusion et démonstration#
Titanic ML Service illustre une démarche de Data Science prolongée par des problématiques concrètes de ML Engineering.
À partir d’un jeu de données pédagogique, le projet a permis de mettre en œuvre :
- Un travail de préparation et de création de variables.
- Une comparaison de plusieurs algorithmes de classification.
- Un pipeline scikit-learn reproductible et sérialisé.
- Une API REST avec FastAPI.
- Des fonctionnalités d’interprétabilité avec SHAP.
- Une interface interactive développée avec Streamlit.
Au-delà de la performance prédictive, cette réalisation met en évidence les difficultés rencontrées lorsqu’un modèle quitte son environnement d’expérimentation pour être utilisé par une application.
Le résultat est un démonstrateur de Machine Learning de bout en bout, associant modélisation, conception logicielle, exposition du modèle et interface utilisateur.
Le code source est disponible sur GitHub.
L’application permet d’expérimenter directement les prédictions du modèle :
Tester l'application Titanic