Peut-on anticiper l’évolution des cours boursiers à l’aide de réseaux neuronaux récurrents ?
Ce projet explore la prévision des cours de cinq actions françaises à partir de modèles Long Short-Term Memory (LSTM), en combinant données financières, variables économiques et analyse de sentiment.
Réalisée en 2021 dans le cadre d’un projet de fin de formation en Data Science, cette étude couvre l’ensemble de la chaîne de traitement : collecte des données, préparation des séries temporelles, entraînement des modèles, évaluation des prédictions et simulation de stratégies d’investissement.
5
Actions étudiées
2020
Période étudiée
3 mois
Période de test
Cette étude présente une expérimentation historique réalisée en 2021. Les résultats rapportés ne constituent ni une validation de stratégie d’investissement rentable ni une démonstration de capacité prédictive généralisable.
1. Problématique#
Les marchés financiers constituent un environnement particulièrement difficile pour la prévision. Les cours évoluent sous l’influence de nombreux facteurs : performances économiques, événements géopolitiques, décisions institutionnelles ou encore comportements des investisseurs.
L’objectif du projet était d’étudier la capacité de modèles de Deep Learning à prévoir le cours de clôture du jour suivant, à partir des observations disponibles sur les jours précédents.
Deux questions ont guidé les expérimentations :
- Les réseaux LSTM permettent-ils d’anticiper les fluctuations des cours boursiers ?
- Ces prévisions peuvent-elles être exploitées pour simuler une stratégie d’achat et de vente ?
L’étude porte sur cinq entreprises françaises appartenant à des secteurs économiques différents.
| Entreprise | Secteur |
|---|---|
| Airbus | Aéronautique et défense |
| Orange | Télécommunications |
| L’Oréal | Cosmétique |
| Renault | Automobile |
| TotalEnergies | Énergie |
Cette diversité permettait d’explorer le comportement des modèles sur des séries présentant des dynamiques différentes.
2. Données et préparation#
2.1. Collecte des données#
La collecte s’est appuyée principalement sur des données financières historiques issues de Yahoo Finance, complétées par plusieurs sources externes.
Différentes catégories de variables ont été étudiées :
| Données | Objectif |
|---|---|
| Cours boursiers historiques | Modéliser la dynamique passée des actions |
| Cours d’entreprises concurrentes | Exploiter d’éventuelles interdépendances sectorielles |
| Matières premières | Étudier l’influence potentielle de l’or, du cuivre, du pétrole ou du gaz |
| Actualités financières | Extraire des indicateurs de sentiment |
| Météorologie et cycles lunaires | Explorer des variables alternatives |
Les cours ajustés de clôture ont été retenus comme variables cibles.
Certaines pistes, notamment les données météorologiques et les cycles lunaires, relevaient d’une démarche exploratoire. Leur collecte ne présupposait pas l’existence d’un pouvoir prédictif.
Une collecte de données issues de Twitter avait également été envisagée, mais les restrictions d’accès aux historiques nécessaires ont conduit à abandonner cette source.
2.2. Préparation des séries temporelles#
Les données ont été regroupées à une granularité journalière, représentant environ 250 observations boursières sur l’année 2020.
La préparation comprenait notamment :
- L’alignement temporel des différentes sources.
- Le traitement des valeurs manquantes par interpolation.
- La mise à l’échelle des variables numériques.
- La transformation des séries en séquences exploitables par les réseaux LSTM.
Les modèles ont principalement été entraînés sur des fenêtres glissantes de cinq observations, afin de prévoir la valeur suivante.
Par exemple, une séquence de cinq cours successifs sert à prédire le cours du sixième jour :
$$ X_t = [y_{t-5},y_{t-4},y_{t-3},y_{t-2},y_{t-1}] $$
$$ \hat{y}_t = \operatorname{LSTM}(X_t) $$
Cette représentation permet au réseau d’exploiter l’évolution temporelle des observations plutôt que de traiter chaque date indépendamment.
Dans le cadre des modèles multivariés, plusieurs variables sont disponibles à chaque pas de temps, notamment les cours d’autres entreprises et les indicateurs externes.
2.3. Pipeline de traitement#
Le projet a été organisé autour d’une chaîne de traitement allant de l’acquisition des données jusqu’à l’évaluation financière.
flowchart TD
    A["Yahoo Finance
Cours historiques"]
    B["Sources externes
Matières premières et concurrents"]
    C["Actualités financières
Titres de presse"]

    D["Collecte et préparation
Python"]
    E["Feature Engineering
Séquences temporelles"]
    F["Modélisation
LSTM / Keras"]
    G["Évaluation
Prédictions et tendances"]
    H["Simulation
Stratégie d'investissement"]

    A --> D
    B --> D
    C --> D
    D --> E
    E --> F
    F --> G
    G --> H
L’analyse de sentiment a constitué une transformation complémentaire des données d’actualité, permettant de produire des variables numériques utilisables lors de certaines expérimentations.
3. Modélisation#
3.1. Pourquoi les réseaux LSTM ?#
Les réseaux Long Short-Term Memory (LSTM) appartiennent à la famille des réseaux neuronaux récurrents (Recurrent Neural Networks).
Ils ont été conçus pour traiter des séquences et apprendre des dépendances temporelles grâce à un mécanisme de mémoire reposant sur différentes portes de contrôle.
Contrairement à un modèle de régression classique appliqué à des observations indépendantes, un LSTM peut apprendre des représentations à partir d’une succession ordonnée de valeurs.
Plusieurs architectures ont été expérimentées.
| Architecture | Principe |
|---|---|
| Vanilla LSTM | Une couche LSTM suivie d’une couche de prédiction |
| Stacked LSTM | Empilement de plusieurs couches LSTM |
| Bidirectional LSTM | Traitement des séquences d’entrée dans les deux sens |
| LSTM multivarié | Intégration de plusieurs variables à chaque pas de temps |
Les premières expérimentations ont été menées sur des modèles univariés, utilisant uniquement l’historique de l’action à prédire.
Des architectures plus complexes ont ensuite été étudiées pour mesurer l’intérêt de couches supplémentaires ou de variables explicatives externes.
3.2. Expérimentations et ajustements#
Plusieurs configurations ont été comparées :
- Variation de la longueur des fenêtres temporelles, notamment entre 5 et 20 jours.
- Modification du nombre de couches et de neurones.
- Ajout de cours boursiers d’entreprises concurrentes.
- Intégration d’indicateurs issus de l’analyse de sentiment.
Les premiers modèles ont rapidement montré une limite : les prédictions reproduisaient parfois la dynamique passée avec un décalage temporel, réduisant leur intérêt pour anticiper les mouvements futurs.
Les architectures empilées et bidirectionnelles ont permis d’obtenir des améliorations sur certaines configurations, sans qu’une architecture ne se révèle systématiquement supérieure.
L’une des observations principales était que les modèles les plus complexes n’obtenaient pas nécessairement les meilleures performances.
3.3. Analyse de sentiment des actualités#
En complément des séries financières, une approche de traitement automatique du langage naturel (Natural Language Processing) a été expérimentée.
Des titres d’articles financiers ont été collectés sur Boursier.com, puis analysés avec la bibliothèque TextBlob.
Cette méthode permet d’associer à un texte un score de polarité compris entre -1 et 1 :
- -1 : sentiment négatif.
- 0 : sentiment neutre.
- +1 : sentiment positif.
Ces scores ont ensuite été intégrés comme variables explicatives lors de certaines expérimentations multivariées.
Les résultats ont été contrastés. Pour certaines actions, l’ajout de ces variables n’a pas amélioré les prédictions et a parfois dégradé leur stabilité.
L’utilisation de modèles de langage plus avancés, notamment BERT et ses adaptations francophones, avait été envisagée comme prolongement, sans être implémentée dans cette version du projet.
4. Résultats#
4.1. Protocole d’évaluation#
Les modèles ont été entraînés sur les neuf premiers mois de l’année 2020, puis évalués sur les trois derniers mois.
Deux dimensions ont été étudiées :
- La qualité des prédictions, à partir de l’erreur de régression et du pourcentage de directions correctement anticipées.
- Les performances financières simulées, en appliquant une stratégie d’investissement basée sur les prévisions du modèle.
L’erreur quadratique moyenne (Mean Squared Error, MSE) était utilisée pendant l’entraînement :
$$ MSE = \frac{1}{N}\sum_{i=1}^{N}(y_i-\hat{y}_i)^2 $$
Cependant, une erreur de régression faible ne garantit pas une bonne anticipation des variations, ni une stratégie financière performante.
Le pourcentage de directions correctement prédites constituait donc un second indicateur d’évaluation.
4.2. Performances des modèles#
Les résultats obtenus sur les cinq actions sont présentés ci-dessous.
| Action | Directions correctes | Portefeuille final |
|---|---|---|
| Airbus | 67 % | 14 526,68 € |
| Orange | 57 % | 10 972,43 € |
| L’Oréal | 52 % | 10 638,99 € |
| Renault | 63 % | 15 495,47 € |
| TotalEnergies | 61 % | 12 823,17 € |
Chaque simulation partait d’un capital fictif de 10 000 €, avec une stratégie d’achat ou de vente fondée sur l’évolution prédite du cours du lendemain.
Les valeurs finales correspondent aux simulations historiques rapportées en 2021. Elles ne représentent pas des gains réellement réalisés sur les marchés financiers.
Les résultats font apparaître plusieurs comportements intéressants.
Airbus a obtenu le meilleur taux de direction correctement anticipée, avec 67 %. Ce résultat provenait d’une architecture relativement simple, comprenant une seule couche LSTM de 50 neurones.
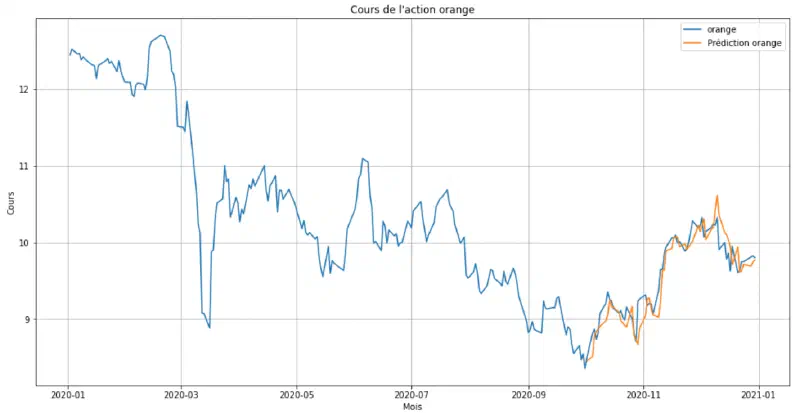
Orange présentait des prédictions relativement proches des valeurs observées, malgré un léger retard dans l’ajustement des mouvements.
L’Oréal a été l’action la plus difficile à modéliser, avec environ 52 % de directions correctement anticipées. L’ajout d’indicateurs de sentiment n’a pas apporté d’amélioration convaincante.
Renault a obtenu une simulation financière particulièrement favorable, mais la forte remontée du cours au dernier trimestre 2020 a joué un rôle important dans ce résultat.
TotalEnergies a fait l’objet d’expérimentations multivariées incluant plusieurs entreprises du secteur énergétique ainsi que des indicateurs de sentiment.
4.3. Simulation de stratégie d’investissement#
La stratégie expérimentée reposait sur des règles simples :
- Achat lorsque le modèle prévoyait une augmentation du cours du lendemain.
- Vente lorsqu’une diminution était anticipée.
Les opérations étaient simulées en tenant compte des frais de courtage prévus dans le projet.
Cette stratégie ne reposait cependant ni sur une optimisation du risque ni sur une allocation sophistiquée du portefeuille. L’hypothèse d’exécution immédiate des ordres constituait également une simplification.
Le contexte de marché doit être pris en compte : le dernier trimestre 2020 correspondait à une phase de rebond de plusieurs actions après les perturbations liées à la pandémie.
Les performances financières observées ne peuvent donc pas être attribuées uniquement aux qualités prédictives des modèles.
5. Limites et enseignements#
Cette expérimentation a mis en évidence plusieurs difficultés fondamentales de la prévision financière.
5.1. Prédire un cours ne signifie pas anticiper une tendance#
Une prévision peut présenter une faible erreur numérique tout en se révélant peu pertinente pour prendre une décision.
Un modèle qui prédit systématiquement une valeur proche du dernier cours observé peut obtenir une erreur relativement faible, mais ne pas anticiper correctement les changements de direction.
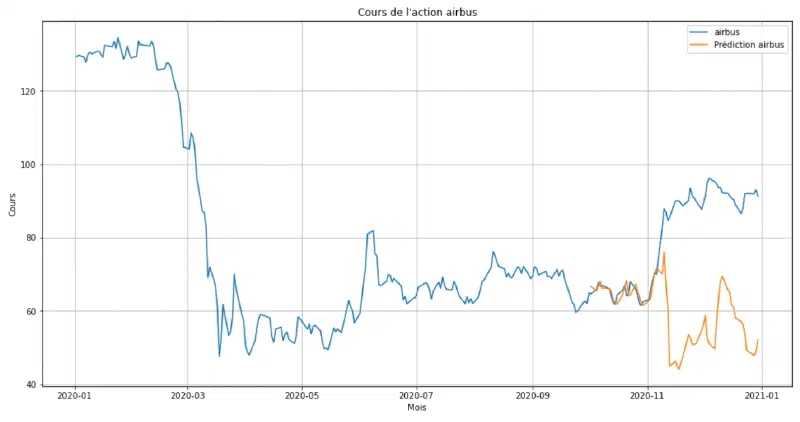
La proximité visuelle entre les courbes réelles et prédites ne suffit donc pas à démontrer la qualité prédictive d’un modèle.
L’évaluation doit être adaptée à l’objectif poursuivi : prévision du niveau du cours, anticipation du rendement ou décision d’investissement.
5.2. Des performances financières dépendantes du marché#
La progression d’un portefeuille simulé ne démontre pas nécessairement la pertinence d’une stratégie.
Dans un marché fortement haussier, une stratégie passive peut également produire des gains importants.
Une évaluation plus robuste nécessiterait notamment :
- Une comparaison avec une stratégie buy-and-hold.
- Des modèles de référence naïfs.
- Plusieurs périodes de test, couvrant différents régimes de marché.
- Une évaluation des risques et des coûts de transaction.
- Une analyse de la stabilité des résultats dans le temps.
Ces comparaisons n’ont pas été suffisamment développées dans l’étude initiale pour établir une surperformance robuste.
5.3. Risques méthodologiques propres aux séries temporelles#
Les données financières imposent également des précautions spécifiques.
L’interpolation à partir d’observations futures, l’ajustement d’un scaler sur l’ensemble des données ou l’utilisation d’informations non encore disponibles au moment de la prédiction peuvent créer une fuite de données temporelle (data leakage).
Le protocole initial ne documente pas suffisamment tous les contrôles nécessaires pour exclure ces risques.
Une approche plus rigoureuse reposerait sur une validation chronologique, avec des fenêtres d’entraînement et de test successives (walk-forward validation), et sur une vérification explicite de la disponibilité temporelle de chaque variable.
Par ailleurs, environ 250 observations journalières représentent un volume limité pour entraîner et comparer des réseaux neuronaux complexes.
5.4. Régression ou classification ?#
Les modèles ont été entraînés pour prédire directement la valeur future des cours.
La décision d’achat ou de vente était ensuite déduite du signe de la variation prédite.
Une autre approche consisterait à modéliser directement le problème comme une classification de la direction du marché :
- Hausse.
- Baisse.
- Éventuellement, absence de signal suffisamment marqué.
Cette formulation permettrait d’aligner plus directement la variable cible sur l’objectif de décision, sans garantir pour autant une meilleure performance financière.
6. Architecture technique#
Au-delà de la modélisation, le projet visait également à couvrir les différentes étapes d’un développement Data Science, depuis la collecte jusqu’à la présentation des résultats.
6.1. Technologies utilisées#
| Domaine | Technologies |
|---|---|
| Développement et traitement | Python Pandas |
| Machine Learning | Scikit-learn |
| Deep Learning | TensorFlow Keras |
| Traitement du langage | TextBlob NLTK |
| Collecte de données | Yahoo Finance Web Scraping |
| Visualisation | D3.js Chart.js |
| Organisation du projet | Cookiecutter Data Science |
| Hébergement historique | Raspberry Pi Nginx Jekyll |
6.2. Organisation et restitution#
Le projet a adopté une organisation inspirée de Cookiecutter Data Science, afin de séparer les données brutes, les transformations, les modèles et les résultats.
Les notebooks Jupyter ont principalement servi aux expérimentations, tandis que certaines fonctions de traitement et d’entraînement ont été regroupées dans des scripts Python.
Les modèles entraînés ont été conservés sous forme d’artefacts sérialisés.
Une interface web avait également été développée pour présenter :
- Les cours réels et les prédictions des cinq actions.
- Les indicateurs de performance des stratégies simulées.
- Les transactions effectuées.
- Les actualités financières collectées.
Cette interface reposait sur JavaScript, D3.js et Chart.js. Elle a été historiquement hébergée sur un Raspberry Pi avec Nginx, dans un site statique Jekyll.
L’industrialisation restait néanmoins partielle, notamment sur l’automatisation des traitements, le réentraînement et l’actualisation des données.
Le tableau de bord historique n’est plus maintenu ; les résultats de l’étude sont désormais présentés directement dans cet article.
Conclusion#
Ce projet a permis d’expérimenter les réseaux LSTM appliqués à la prévision de séries temporelles financières, en intégrant différentes architectures et plusieurs catégories de variables explicatives.
Les résultats ont montré que certaines configurations parvenaient à anticiper une proportion intéressante des directions boursières sur la période étudiée. Ils ont également mis en évidence les difficultés d’interprétation propres à la prévision financière.
Trois enseignements principaux en ressortent :
- La complexité du modèle n’est pas une garantie de performance. Les architectures simples se sont parfois révélées plus efficaces que les configurations plus élaborées.
- La qualité d’une prévision dépend de son objectif d’utilisation. Une faible erreur numérique ne se traduit pas nécessairement par une bonne décision.
- L’évaluation temporelle est déterminante. Les performances d’un modèle doivent être interprétées en tenant compte du contexte de marché, des références de comparaison et des risques de fuite d’information.
L’intérêt principal de cette étude réside ainsi autant dans la démarche expérimentale que dans les résultats obtenus.
Elle constitue une première mise en pratique de la modélisation de séries temporelles, du Deep Learning et des problématiques d’évaluation associées aux systèmes de prévision.
Rapport original#
Cette étude a été réalisée en 2021 dans le cadre du Diplôme Universitaire Big Data, Data Sciences & Analyse des risques sous Python.
Le rapport académique original présente le détail des expérimentations, les architectures LSTM étudiées, les résultats des simulations et les choix techniques du projet.
Consulter le rapport complet (PDF)